Apa Itu RAG (Retrieval-Augmented Generation)? Ini Cara Kerja dan Penerapannya
Coba bayangkan begini, kamu sedang membuat sebuah aplikasi berbasis AI menggunakan LLM, lalu kamu coba tanyakan sesuatu yang spesifik soal dokumen perusahaan misalnya isi SOP terbaru, kebijakan cuti karyawan, atau detail kontrak dengan klien tertentu. Hasilnya? Bisa jadi LLM menjawab "saya tidak punya informasi tersebut", atau lebih parah lagi, dia tetap menjawab dengan percaya diri padahal isinya ngarang alias halusinasi.
Ini wajar terjadi, karena LLM hanya "tahu" apa yang dipelajari saat proses training dan dokumen internal perusahaan jelas bukan bagian dari data training itu. Nah, di titik inilah pertanyaannya muncul, gimana caranya supaya LLM bisa menjawab berdasarkan dokumen perusahaan kita sendiri, tanpa harus melatih ulang model dari nol? Jawabannya adalah Retrieval-Augmented Generation (RAG).
Kenapa RAG Dibutuhkan?
Sebelum masuk ke definisinya, ada baiknya kita pahami dulu masalah apa yang sebenarnya coba diselesaikan. Ada beberapa masalah utama yang muncul saat kita membangun aplikasi AI dengan LLM begitu saja, tanpa tambahan apa pun.
Tidak tahu data internal
LLM standar tidak pernah "membaca" dokumen perusahaan, SOP, katalog produk, atau riwayat pelanggan kita, jadi wajar kalau ditanya soal itu dia tidak bisa jawab.
Halusinasi
Sifat LLM yang banyak menjadi kendala salah satunya adalah halusinasi. Bukanya bilang "tidak tahu", LLM kadang malah "mengarang" jawaban yang terdengar meyakinkan padahal salah, terutama saat ditanya hal yang tidak dikuasainya. Ini yang paling berbahaya kalau dipakai di aplikasi bisnis.
Keterbatasan pengetahuan (knowledge cutoff)
LLM juga tidak tahu kejadian atau data setelah tanggal trainingnya berakhir, jadi info yang diberikan bisa saja sudah kedaluwarsa.
Biaya fine-tuning yang mahal
Salah satu cara "mengajari" LLM data baru adalah dengan fine-tuning, tapi itu mahal dan memakan waktu, apalagi kalau dokumen perusahaan terus bertambah dan berubah setiap saat. Perbedaanya akan kita bahas di artikel lainya.
Dari masalah-masalah inilah, muncul sebuah pendekatan bernama Retrieval-Augmented Generation (RAG)
Apa Itu RAG?
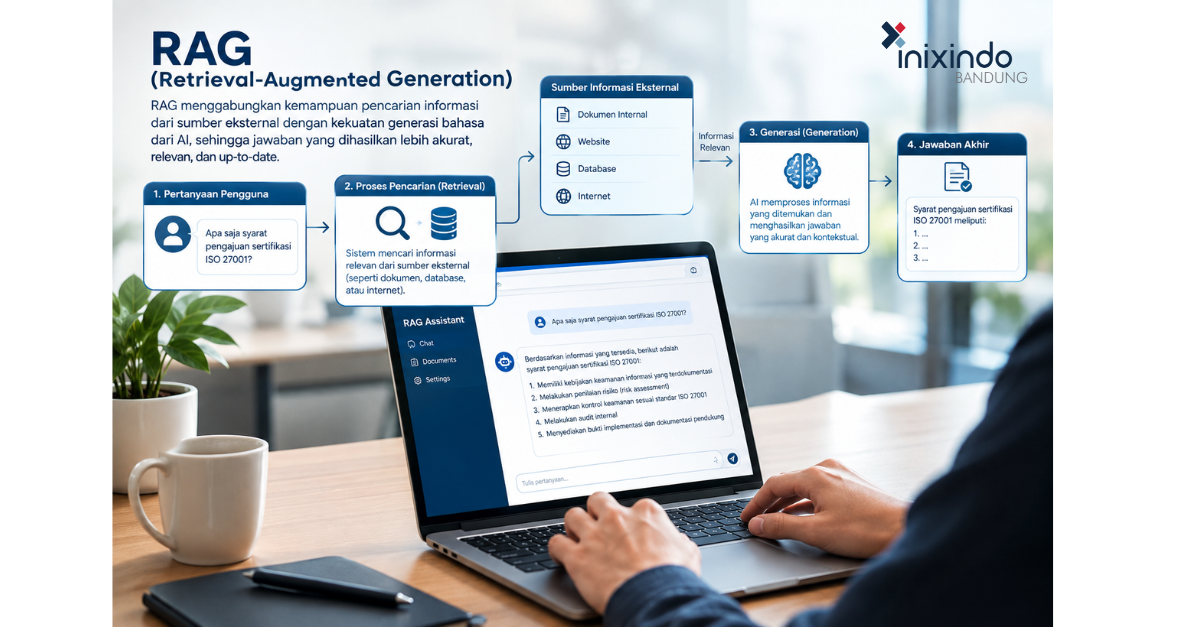
RAG adalah sebuah pendekatan yang menggabungkan dua kemampuan sekaligus pencarian informasi (retrieval) dan kemampuan menghasilkan teks (generation) dari LLM. Konsep RAG ini bukan hanya mengandalkan pengetahuan yang sudah "dihafal" selama training, melaikan RAG akan mencari informasi relevan terlebih dahulu dari sumber data eksternal seperti dokumen, database, atau halaman web baru kemudian menggunakan informasi itu untuk menyusun jawaban.
AWS juga menjelaskan bahwasanya RAG adalah teknik untuk memperkaya LLM dengan data eksternal, seperti dokumen internal perusahaan, sehingga model punya konteks yang dibutuhkan untuk menghasilkan output yang akurat dan berguna sesuai kebutuhan spesifik penggunanya. Bagi AWS, ini menjadikan RAG sebagai pendekatan yang pragmatis dan efektif untuk memakai LLM di lingkungan enterprise.
Sederhananya, RAG membuat LLM bekerja seperti seseorang yang membuka referensi dulu sebelum menjawab pertanyaan, bukan menjawab hanya berdasarkan ingatan semata.
Cara Kerja RAG
Banyak refrensi yang sudah menjelaskan cara kerja RAG dengan alur yang pada dasarnya sama, hanya berbeda penyebutan tahapannya. Secara garis besar, sistem RAG bekerja dalam beberapa tahap berikut:
Query dari pengguna
Pengguna mengajukan pertanyaan atau perintah.
Retrieval (pencarian)
Sistem mencari potongan informasi yang paling relevan dari basis data eksternal, biasanya menggunakan teknik pencarian berbasis vector (embedding) agar bisa menemukan konteks yang mirip secara makna, bukan cuma kata kunci yang sama persis.
Augmentation (penggabungan konteks)
Potongan informasi yang ditemukan tadi digabungkan dengan pertanyaan asli pengguna, membentuk prompt baru yang lebih kaya konteks.
Generation (penyusunan jawaban)
LLM menggunakan prompt yang sudah diperkaya ini untuk menyusun jawaban akhir, sehingga jawabannya lebih akurat dan berbasis data nyata. Proses ini membuat LLM tetap bisa menjawab dengan gaya bahasa alami, tapi isinya didukung oleh data yang benar-benar relevan dan up-to-date.
Kesimpulan
RAG adalah salah satu terobosan penting yang membuat LLM jadi lebih andal, akurat, dan relevan dengan kebutuhan nyata. Dengan menggabungkan kemampuan pencarian data eksternal dan kekuatan generatif LLM, RAG membantu mengatasi masalah klasik seperti halusinasi dan keterbatasan pengetahuan, sekaligus membuka peluang penerapan di berbagai bidang, mulai dari chatbot, pencarian dokumen, hingga sistem yang dijalankan sepenuhnya di infrastruktur internal perusahaan (on-premise).
Kedepannya, seiring makin banyak organisasi yang mengandalkan data mereka sendiri untuk membangun aplikasi AI, RAG kemungkinan besar akan menjadi salah satu fondasi utama dalam pengembangan sistem berbasis LLM.
Referensi
AWS, (2024). Understanding Retrieval Augmented Generation